Bacterial Stress CRN SDE Ensemble
Chemical Langevin ensemble of the four-species generalised bacterial stress response network from Utkarsh et al., Comput. Methods Appl. Mech. Eng. 428 (2024) 117109 (arXiv:2304.06835; artifacts, credit Torkel Loman for the Catalyst network). The paper converted a Catalyst SDEProblem through ModelingToolkit into an out-of-place StaticArray form. This notebook uses that CLE directly so the benchmark does not depend on Catalyst / MTK conversion.
Species $(\sigma, A_1, A_2, A_3)$, parameters $(S, D, \tau, v_0, n, \eta)$. Production / degradation pairs:
\[\emptyset \leftrightarrow \sigma\]
at $v_0 + \frac{(S\sigma)^n}{(S\sigma)^n + (DA_3)^n + 1}$ and $\sigma$\[\emptyset \leftrightarrow A_1\]
at $\sigma/\tau$ and $A_1/\tau$\[\emptyset \leftrightarrow A_2\]
at $A_1/\tau$ and $A_2/\tau$\[\emptyset \leftrightarrow A_3\]
at $A_2/\tau$ and $A_3/\tau$
Diffusion columns are $\eta\,\nu_j\sqrt{r_j}$. $t \in [0, 1000]$, EM / GPUEM with $dt = 0.1$. Parameter grids are the paper's; $N$ is the number of $S$ and $D$ log-spaced samples (the runner used $N = 2, 4$).
using Printf
using CUDA
using DiffEqGPU, StochasticDiffEq, StaticArrays
using Plots

@assert CUDA.functional() "This benchmark requires a functional CUDA GPU"
println("GPU: ", CUDA.name(CUDA.device()))

const BACKEND = CUDA.CUDABackend()
const KERNEL = EnsembleGPUKernel(BACKEND, 0.0)

gr()
GPU: Tesla V100-PCIE-32GB
Plots.GRBackend()function crn_f(u, p, t)
T = eltype(u)
σ, A1, A2, A3 = u
S, D, τ, v0, n, η = p
hill_num = (S * σ)^n
hill = hill_num / (hill_num + (D * A3)^n + one(T))
dσ = v0 + hill - σ
dA1 = (σ - A1) / τ
dA2 = (A1 - A2) / τ
dA3 = (A2 - A3) / τ
return SVector{4, T}(dσ, dA1, dA2, dA3)
end
function crn_g(u, p, t)
T = eltype(u)
σ, A1, A2, A3 = u
S, D, τ, v0, n, η = p
z = zero(T)
hill_num = (S * σ)^n
hill = hill_num / (hill_num + (D * A3)^n + one(T))
s1 = η * sqrt(max(v0 + hill, z))
s2 = η * sqrt(max(σ, z))
s3 = η * sqrt(max(σ / τ, z))
s4 = η * sqrt(max(A1 / τ, z))
s5 = η * sqrt(max(A1 / τ, z))
s6 = η * sqrt(max(A2 / τ, z))
s7 = η * sqrt(max(A2 / τ, z))
s8 = η * sqrt(max(A3 / τ, z))
return SMatrix{4, 8, T}(
s1, z, z, z,
-s2, z, z, z,
z, s3, z, z,
z, -s4, z, z,
z, z, s5, z,
z, z, -s6, z,
z, z, z, s7,
z, z, z, -s8
)
end
function crn_parameters(N; T::Type = Float32)
S_grid = T.(10 .^ range(T(-1), stop = T(2), length = max(N, 2))[1:N])
D_grid = T.(10 .^ range(T(-1), stop = T(2), length = max(N, 2))[1:N])
τ_grid = T[0.1, 0.15, 0.20, 0.30, 0.50, 0.75, 1.0, 1.5, 2.0, 3.0, 5.0, 7.50,
10.0, 15.0, 20.0, 30.0, 50.0, 75.0, 100.0][1:2:19]
v0_grid = T[0.01, 0.02, 0.03, 0.05, 0.075, 0.1, 0.15, 0.20]
n_grid = T[2.0, 3.0, 4.0]
η_grid = T[0.001, 0.002, 0.005, 0.01, 0.02, 0.05, 0.1]
return collect(Iterators.product(S_grid, D_grid, τ_grid, v0_grid, n_grid, η_grid))
end
function make_crn_ensemble(parameters; T::Type = Float32)
u0 = SVector{4, T}(T(0.1), T(0.1), T(0.1), T(0.1))
tspan = (zero(T), T(1000))
p0 = SVector{6, T}(T(2.3), T(5), T(10), T(0.1), T(3), T(0.1))
g0 = zeros(SMatrix{4, 8, T})
prob = SDEProblem{false}(crn_f, crn_g, u0, tspan, p0; noise_rate_prototype = g0)
function prob_func(prob, ctx)
pi = parameters[ctx.sim_id]
remake(prob;
p = SVector{6, T}(pi[1], pi[2], pi[3], pi[4], pi[5], pi[6]),
u0 = SVector{4, T}(pi[4], pi[4], pi[4], pi[4]))
end
return EnsembleProblem(prob, prob_func = prob_func, safetycopy = false)
end
function min_seconds(fn; warmup = 1, samples = 3)
for _ in 1:warmup
fn()
end
ts = Vector{Float64}(undef, samples)
for i in 1:samples
ts[i] = @elapsed fn()
end
return minimum(ts)
endmin_seconds (generic function with 1 method)let
ps = crn_parameters(2)
ens = make_crn_ensemble(ps)
sol = solve(ens, GPUEM(), KERNEL; trajectories = 2, save_everystep = false,
adaptive = false, dt = 0.1f0)
println("CRN smoke: 2 trajectories, u[1][end] = ", sol.u[1].u[end])
@assert all(i -> length(sol.u[i].u[end]) == 4, 1:2)
endCRN smoke: 2 trajectories, u[1][end] = Float32[0.009919406, 0.010128644, 0.
010087123, 0.010349157]const NS = [2, 4]
ntraj = Int[]
t_gpu = Float64[]
t_cpu = Float64[]
for N in NS
ps = crn_parameters(N)
n = length(ps)
push!(ntraj, n)
@info "crn gpu" N n
ens = make_crn_ensemble(ps)
push!(t_gpu,
min_seconds(() -> (CUDA.@sync solve(ens, GPUEM(), KERNEL; trajectories = n,
save_everystep = false, adaptive = false, dt = 0.1f0); nothing)))
@info "crn cpu" N n
ens64 = make_crn_ensemble(crn_parameters(N; T = Float64); T = Float64)
push!(t_cpu,
min_seconds(() -> (solve(ens64, EM(), EnsembleThreads(); trajectories = n,
save_everystep = false, adaptive = false, dt = 0.1); nothing);
samples = 2))
endp = plot(ntraj, t_gpu .* 1e3; xscale = :log10, yscale = :log10,
xlabel = "trajectories", ylabel = "time (ms)",
label = "GPUEM + EnsembleGPUKernel", marker = :circle, legend = :topleft,
title = "CRN SDE ensemble, EM dt = 0.1")
plot!(p, ntraj, t_cpu .* 1e3; label = "EM + EnsembleThreads", marker = :utriangle)
p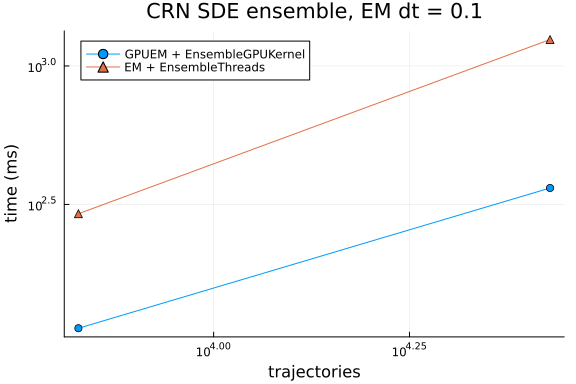
println("CRN SDE (ms)")
@printf("%6s %10s %12s %12s\n", "N", "traj", "GPU", "CPU")
for (i, N) in enumerate(NS)
    @printf("%6d %10d %12.3f %12.3f\n", N, ntraj[i], t_gpu[i] * 1e3, t_cpu[i] * 1e3)
end
CRN SDE (ms)
N traj GPU CPU
2 6720 112.922 292.660
4 26880 362.481 1246.000